La tecnología está en constante evolución y vale la pena mantenerse al día con las últimas tendencias. Uso plataformas educativas para desarrollar mis habilidades de desarrollo web y aprender nuevos idiomas. Un aspecto de estas páginas que aprecio especialmente es su gamificación del proceso de aprendizaje.
¿A qué me refiero con gamificación? La plataforma muestra una barra de progreso cuando comienza la lección para mostrarle exactamente cuánto ha avanzado en el curso (vea la captura de pantalla a continuación). No solo puedo ver todas las lecciones que he completado, sino también cuánto he movido el contador. Esto me inspira a dar un paso más con cada sesión porque sé exactamente cuánto me he quedado antes de conseguir el trofeo.
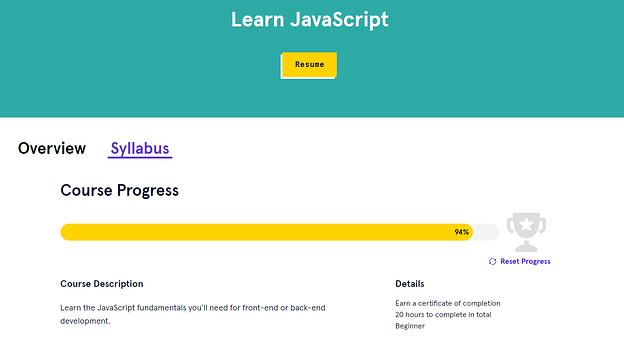
Aquí la definición de éxito es clara: complete un curso de JavaScript y obtenga la certificación. Sin embargo, ¿cómo define el éxito en un sistema complejo y conectado como DevOps que no es un camino de desarrollo lineal como un curso en línea? La clave del éxito es encontrar formas de medir nuestro progreso hacia una meta, como un contador de finalización de cursos en línea.
Cómo medir el éxito de DevOps
El objetivo del modelo DevOps es producir software de mayor calidad más rápido y responder rápidamente a los requisitos y tecnologías cambiantes para mantener el producto a la vanguardia. Si su equipo logra esta visión, aprovecha al máximo la metodología DevOps.
¿Cómo sabes si has llegado a este punto? Los clientes y usuarios finales satisfechos son una buena señal. Pero incluso si está satisfecho con sus partes interesadas, hay otras consideraciones, como el rendimiento de la aplicación, que pueden no estar causando problemas inmediatos, pero pueden causarlos en el futuro. Necesitamos una forma de medir nuestros indicadores clave de rendimiento (KPI) para determinar si estamos cumpliendo nuestros objetivos e identificar oportunidades de mejora.
Ya sea que persiga sus objetivos o siga el modelo DevOps, las métricas nos ayudan a descubrir problemas ocultos y validar dónde sobresalimos. Las métricas de DevOps también nos permiten detectar caídas en nuestros KPI temprano para que podamos solucionar problemas antes de que disminuya la satisfacción del cliente. influencia. Los mejores equipos de DevOps reciben comentarios de las partes interesadas e implementan cambios rápidamente con conocimiento y planificación.
¿Qué son las métricas de DevOps?
Las métricas de DevOps son estadísticas y puntos de datos que se correlacionan con el rendimiento del modelo DevOps del equipo y miden el rendimiento del proceso, y también revelan cualquier área de fricción entre las fases de la canalización. Las métricas se utilizan para realizar un seguimiento del progreso hacia los objetivos generales establecidos por el equipo.
Ahora que entendemos las métricas de DevOps, pasemos a las ocho métricas más relevantes para evaluar el rendimiento y el éxito de una canalización de DevOps.
Métricas importantes de DevOps
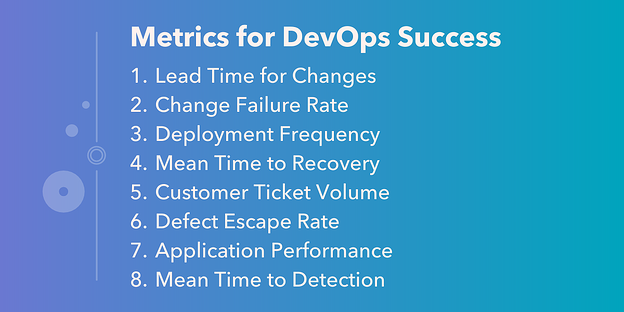
- Tiempo de implementación de los cambios.
- Cambiar la tasa de fracaso
- Frecuencia de implementación
- Tiempo medio de recuperación
- El número de tickets de clientes.
- Tasa de escape de defectos
- Rendimiento de la aplicación
- Tiempo medio de detección
Las primeras cuatro métricas de nuestra lista fueron seleccionadas por el equipo de investigación y evaluación de DevOps (DORA) de Google como puntos críticos de datos. Analizaremos estas y cuatro métricas adicionales para brindarle una mejor perspectiva del rendimiento de su canalización.
1. Tiempo de implementación de cambios
El tiempo para realizar cambios es el tiempo entre la confirmación del nuevo código y el estado compilado e implementado. En el modelo DevOps, las actualizaciones rápidas son fundamentales para mantener la excelencia y el impulso, por lo que es esencial optimizar el proceso de prueba y conectividad.
Los equipos implementarán prácticas de automatización de DevOps para lograr un nuevo rendimiento en los procesos de prueba y construcción. El tiempo para realizar cambios le permite al equipo ver exactamente cuánto tiempo lleva realizar cambios en el código para la producción.
2. Cambiar la tasa de fracaso
La tasa de errores de cambio registra el porcentaje de actualizaciones que requieren reparaciones o atención inmediata después de implementarse en un entorno de producción. Este indicador no tiene en cuenta los problemas encontrados antes de implementaciones, y los equipos pueden ver esta métrica como un reflejo de la efectividad de su sistema de prueba.
En otras palabras, una alta tasa de fallas en los cambios podría indicar una falla en el proceso de prueba de DevOps, además de otros posibles problemas de producción. Los errores de cambio no son perfectos, ya que esto significa que el código incorrecto está llegando a los clientes y ocupando los recursos del equipo para implementar soluciones urgentes. Esto significa que la tasa de errores de cambio es un punto de datos clave para evaluar la eficacia de las prácticas de prueba y la calidad del código del equipo.
3. Frecuencia de implementación
La frecuencia de implementación se relaciona con el objetivo final de DevOps: desarrollar software de alta calidad rápidamente. Por supuesto, medir la frecuencia con la que el equipo pone código nuevo en producción muestra cómo la canalización está haciendo frente a ese objetivo. La frecuencia de implementación proporciona esta información.
Sin embargo, es importante sopesar esta métrica con la tasa de fallas de cambio discutida anteriormente. Si su equipo implementa código con frecuencia, pero ese código suele tener errores, el proceso no es tan eficiente como la frecuencia de implementación. solo sugirió. Las implementaciones incorrectas también conducirán a una menor satisfacción del cliente, especialmente si los problemas afectan la experiencia del usuario.
4. Tiempo medio de recuperación
El tiempo medio de recuperación (MTTR) en el modelo DevOps es una medida del tiempo que tarda una aplicación implementada en recuperarse de un bloqueo y volver al funcionamiento normal. MTTR no distingue entre la interrupción del servicio debido a la implementación del código o una falla importante del sistema.
Es necesaria una estrategia de monitoreo de aplicaciones para reducir el MTTR. Las herramientas de monitoreo y registro acelerarán el tiempo de detección y también pueden identificar la causa de un bloqueo. Uno de los puntos fuertes de DevOps es la colaboración entre los equipos operativos y de desarrollo, lo que permite una identificación y reparación de problemas más rápida.
5. El volumen de tickets de clientes
Si bien DORA no lo seleccionó, la cantidad de envíos de los clientes es un indicador crítico para medir hasta qué punto el software satisface las necesidades del usuario final. La retroalimentación es esencial para que el modelo DevOps enfatice la mejora continua, y la retroalimentación de los clientes es una fuente de datos que le permite enfocar sus esfuerzos en resolver problemas recurrentes.
Sin embargo, una gran cantidad de informes de clientes sugieren que su aplicación no satisface las principales necesidades de los clientes. La capacidad de catalogar rápidamente las entradas le dará una visión general de los problemas y su gravedad. En cada escenario, menos problemas de los clientes indican que su aplicación está cumpliendo con las expectativas y funcionando según sea necesario. Los volúmenes más altos indican que necesita retroceder y reevaluar su enfoque.
6. Tasa de escape de defectos
La tasa de escape de defectos mide la velocidad a la que se pone en producción el código que contiene errores u otros defectos. Al igual que la tasa de fallas del cambio, es otra medida de la efectividad del proceso de prueba y la estrategia general de control de calidad (QA).
Sin embargo, la tasa de escape de defectos se enfoca únicamente en el porcentaje de salidas de producción con código no válido frente a la tasa de fallas de cambio, que registra cuántas de estas salidas requieren reparación inmediata. Juntas, estas métricas brindan una mejor perspectiva de las áreas en las que el proceso de control de calidad puede mejorar, para detectar errores antes en el proceso y el impacto de los errores no detectados.
7. Rendimiento de la aplicación
El rendimiento de la aplicación mide cómo la aplicación resiste varios requisitos de recursos y satisface las necesidades de los usuarios durante el rendimiento normal y máximo. Idealmente, la aplicación tiene una base sólida para responder a grandes solicitudes sin afectar los tiempos de carga de los usuarios.
El rendimiento de la aplicación medirá cómo responde la aplicación a escenarios de alta demanda. Estas pruebas se realizan antes de la implementación para confirmar que el software cumplirá con los requisitos específicos del cliente. Después de la implementación, los equipos de DevOps continuarán monitoreando el rendimiento para asegurarse de que la aplicación funcione como se espera en producción. Las caídas en el rendimiento de las aplicaciones significan problemas potenciales para la evaluación y corrección proactivas.
8. Tiempo medio de detección
El tiempo medio de detección (MTTD) es una medida del tiempo que lleva identificar y marcar un problema después de que aparece en producción. Esto se correlaciona directamente con la supervisión del rendimiento de la aplicación como medio principal para detectar problemas, aunque los informes de los clientes son otra fuente de comentarios.
Cuanto antes se detecte un error, antes podrá el equipo investigarlo y corregirlo. Un MTTD corto muestra que su equipo tiene una estrategia de monitoreo efectiva y está respondiendo a los problemas emergentes. Junto con un MTTR corto, su equipo identifica y resuelve problemas a escala, idealmente antes de que el cliente note un problema con la aplicación.
Tableros de DevOps
Puede encontrar métricas adicionales que son valiosas para el modelo DevOps único de su equipo, más allá de las ocho que hemos cubierto aquí. Entonces, ¿cómo organiza esta información en un formato accesible con gráficos y ayudas visuales, en lugar de tratar de clasificar sus hojas de cálculo?
En el ejemplo anterior, la definición de éxito es clara y se divide en pasos prácticos. Su progreso se refleja en el Tablero del curso que muestra la barra de finalización y las lecciones completadas.
Los equipos de DevOps pueden usar paneles para realizar un seguimiento de su progreso y comprender mejor los datos complejos.

Los paneles son una excelente manera de visualizar estadísticas complejas y ponerlas a disposición de un público más amplio. Compartir paneles con su equipo les permite participar en el seguimiento de objetivos e inspira un mayor sentido de responsabilidad. También puede usar tableros para mostrar a la gerencia de la empresa que su modelo DevOps está cumpliendo sus objetivos.
A continuación, analizaremos tres tipos diferentes de tableros que puede implementar.
1. Cuadros de mando para la gestión ágil de proyectos
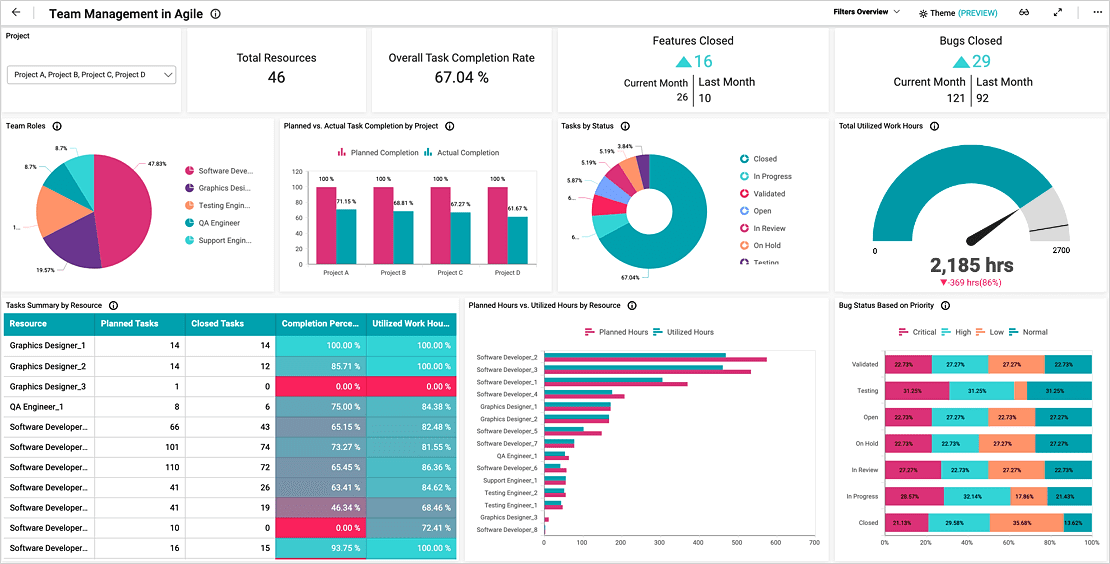
Los paneles de administración de proyectos ágiles se enfocan en medir y visualizar los flujos de trabajo de desarrollo de aplicaciones. Estos paneles le mostrarán cómo su equipo se enfrenta a objetivos como las fechas de vencimiento y la finalización de tareas. También brindan una mejor perspectiva para establecer expectativas, como el tiempo de entrega promedio para crear un componente de software específico.
2. Tableros de monitoreo de aplicaciones
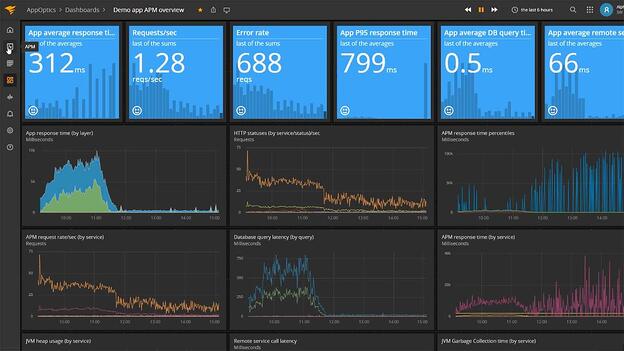
Los paneles de supervisión de aplicaciones están dedicados a registrar el rendimiento de las aplicaciones en un entorno de producción. Estos datos ayudan a establecer puntos de referencia para las operaciones normales que luego ayudan a marcar el rendimiento por debajo del promedio para un mayor escrutinio.
Los paneles de monitoreo de aplicaciones también pueden agregar envíos de clientes por patrón, tipo de registro y frecuencia de error, y registrar MTTD y MTTR para brindar una vista completa del estado de la aplicación.
3. Mesas de observación de la plataforma
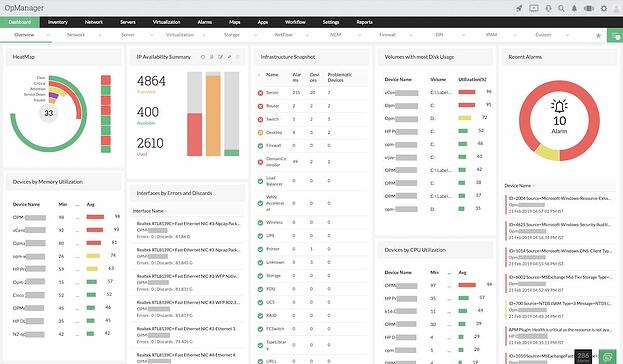
Los tableros de observación de la plataforma brindan una vista diferente del estado de la aplicación, pero estos tableros se enfocan en toda la pila de tecnología. Este alcance cubre los contenedores de aplicaciones, la red y el almacenamiento para medir si la infraestructura subyacente admite el rendimiento del software.
La información de estos paneles ayuda al equipo de operaciones a configurar mejor el entorno para permitir que el servidor responda rápidamente a las solicitudes de los clientes y otros comportamientos deseados.
Mida dos veces, corte una vez.
Sé que DevOps no es lo mismo que chatarra, pero escúchame. El proverbio «mide dos veces, corta una vez» se refiere a un enfoque más profundo de los datos: cuanta más información recopilemos, más informadas serán nuestras decisiones. En la práctica, esto puede ser tan simple como medir una segunda vez, solo para asegurarse de marcar la longitud correcta en su 2×4 antes de recortarlo.
Por supuesto, el modelo DevOps es exponencialmente más complejo que usar una sierra. Pero al igual que nuestro carpintero teórico, su objetivo es recopilar la mayor cantidad de datos posible de tantas fuentes como sea posible para tomar decisiones que tengan en cuenta el contexto completo de su equipo y canalización. Al priorizar las métricas de DevOps que cubrimos en esta publicación, podrá fortalecer sus juicios con números concretos y establecer objetivos medibles para impulsar a su equipo.