Comencemos con un escenario hipotético. Trabajamos para una empresa de software comercial y nuestro equipo de soporte recibió comentarios del Cliente A y del Cliente B. A ambos clientes les gustaría que se agregara una característica diferente a nuestra plataforma. Con recursos de programación limitados, ¿cómo elegir la función que desea usar primero?
Necesitamos más datos para priorizar. Al verificar nuestro sistema en el punto de venta, ahora podemos ver que el Cliente A ha comprado un nivel más caro de nuestro producto que el Cliente B. Sin embargo, en nuestra base de datos de renovación, podemos ver que el Cliente A seleccionó no renueve su suscripción, mientras que el Cliente B es renovando
Al combinar datos relevantes de diferentes fuentes en nuestra organización, comprendemos mejor el problema y ahora podemos redefinir la pregunta original: ¿estamos tratando de recuperar al Cliente A resolviendo sus problemas? ¿O tal vez tratamos las necesidades del Cliente B como una prioridad, porque sabemos que seguirá usando el producto? La respuesta dependerá de las prioridades comerciales de nuestra organización, pero ahora estamos viendo cómo el contexto basado en datos puede dar forma a nuestras decisiones para que sean más estratégicas.
A menos que tengamos una fuente centralizada para toda esta información, tomar decisiones informadas se vuelve mucho más difícil. Por lo tanto, las organizaciones recurrieron a ETL para proporcionar el contexto necesario para comprender sus datos y establecer prioridades respaldadas por las estadísticas que poseen.
¿Qué es ETL?
ETL significa «extraer, transformar, cargar». Este es el modelo estándar para las organizaciones que buscan integrar datos de múltiples fuentes en un único repositorio de datos centralizado.
Las principales ventajas de ETL son:
- Calidad: ETL mejora la calidad de los datos mediante la transformación de datos de varias bases de datos, aplicaciones y sistemas para cumplir con los requisitos de cumplimiento internos y externos. Esta consolidación proporciona un contexto histórico ya que todos los datos relevantes se catalogan para su descubrimiento, eliminando así los puntos ciegos en el proceso de toma de decisiones.
- Cohesión: ETL simplifica el análisis al transformar los datos de acuerdo con un estándar universal. ETL también mejora la precisión de los cálculos y pronósticos cuando todos los datos se archivan y se pueden buscar.
- Velocidad: ETL mejora la velocidad de toma de decisiones al eliminar la necesidad de sondear múltiples fuentes de datos, todas las cuales pueden tener diferentes tiempos de respuesta, para crear una imagen completa.
Para una explicación alternativa de ETL y sus beneficios, vea este video:
Entonces, ¿cómo funciona ETL? Rompamos el proceso.
Extraer, Convertir, Cargar: Proceso ETL
Como sugiere el acrónimo, ETL consta de tres fases separadas: extracción, transformación y carga. Examinaremos cada proceso individualmente.
1. Extracto
La mayoría de las empresas confían en múltiples flujos de datos de una variedad de fuentes y formatos. Podemos recordar el ejemplo hipotético del Cliente A y el Cliente B y los puntos de datos tomados de cada cliente. Antes de que estos datos puedan analizarse, primero deben ubicarse, copiarse y trasladarse a un almacén de datos central. Esta es la fase de extracción del proceso ETL.
Vale la pena señalar que los datos pueden provenir de varias fuentes, no solo de las bases de datos tradicionales. Los datos sin procesar se pueden extraer de fuentes no estructuradas, como documentos, correos electrónicos e imágenes, o de fuentes estructuradas, como bases de datos. La extracción es la forma en que se ubican y copian todos estos datos diferentes para que podamos formatearlos de acuerdo con nuestras necesidades en la siguiente fase.
2. Convertir
Ahora que se han recopilado los datos, es necesario procesarlos. Como esta información proviene de diferentes sistemas en diferentes formatos, necesitamos manipularla para mantener la integridad de los datos y hacerla interrogativa. De acuerdo con las reglas predefinidas, el proceso de transformación limpiará, estandarizará, deduplicará, verificará, mapeará y ordenará los datos para garantizar que estén listos para cargarse en el almacén de datos en la siguiente fase.
3. Subir
Ahora los datos transformados se cargan en el almacén de datos. Hay dos métodos comunes de transferencia de datos: carga completa y carga incremental.
Cuando está completamente cargado, cada punto de datos recopilado durante las fases de extracción y transformación se coloca en registros nuevos y únicos en el almacén de datos. Si bien puede parecer perfecto, este método puede hacer que los conjuntos de datos crezcan exponencialmente con el tiempo y se vuelvan inmanejables.
Un enfoque más amigable con los recursos es el método de carga incremental donde los datos entrantes se comparan con los datos existentes y la información única se completa como nuevos registros. Aunque es menos integral que el enfoque de carga completa, la carga incremental requiere almacenes de datos más pequeños que requieren menos mantenimiento.
El propio proceso de carga también puede tener lugar en diferentes intervalos de tiempo. La carga completa y la carga incremental generalmente ocurren a intervalos programados. Algunas organizaciones han sincronizado completamente su proceso para que los nuevos datos se extraigan, transformen y carguen tan pronto como se registren en su origen, lo que garantiza una visibilidad en tiempo real. Sin embargo, esto requiere una estrecha integración entre las fuentes de datos, las herramientas ETL y el almacén de datos, y puede no ser apropiado en todos los escenarios.
Este video muestra otro estudio del proceso ETL:
El modelo ETL y el modelo ELT
ETL es la forma en que las organizaciones capturaron primero todos sus datos y obtuvieron una mayor visibilidad de sus operaciones. Sin embargo, con el avance de la computación en la nube, algunas empresas ahora están recurriendo al modelo de extracción, carga y transformación (ELT). Compararemos los dos, comenzando con el modelo ETL.
Modelo ETL tradicional
En un modelo ETL tradicional, los datos se extraen de las fuentes de datos, se transforman para cumplir con los requisitos de validación y se cargan en un almacén de datos empresarial. Los almacenes de datos tienen un esquema de datos, metadatos y reglas de validación estrictos para garantizar que todos los datos estén estructurados y se puedan buscar según los requisitos de su organización. Esto, a su vez, significa que todos los datos deben transformarse para cumplir con estos requisitos en el área de preparación antes de que lleguen al almacén de datos.
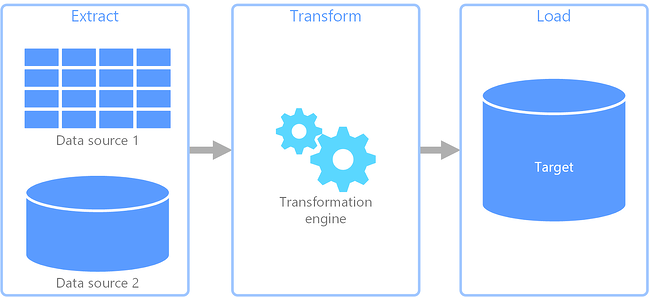
Una desventaja de este enfoque es que el procesamiento de datos se lleva a cabo antes de que lleguen a su destino, y si el conjunto de datos es grande o complejo, esto puede retrasar la entrega. El ELT es un nuevo enfoque que las organizaciones están adoptando para abordar este problema.
Modelo ELT con soporte en la nube
En el modelo ELT, los datos se extraen, se cargan en el almacén de datos y Siguiente transformado para cumplir con las reglas de validación. La principal ventaja de este enfoque es que el procesamiento se lleva a cabo en el propio almacén de datos y no en el ELT que recopila los datos. Con la adopción generalizada de la computación en la nube, las empresas están aprovechando el poder de cómputo de la infraestructura de un proveedor de servicios en la nube (CSP), lo que conducirá a una entrega de datos más rápida y tiempos de procesamiento más cortos.
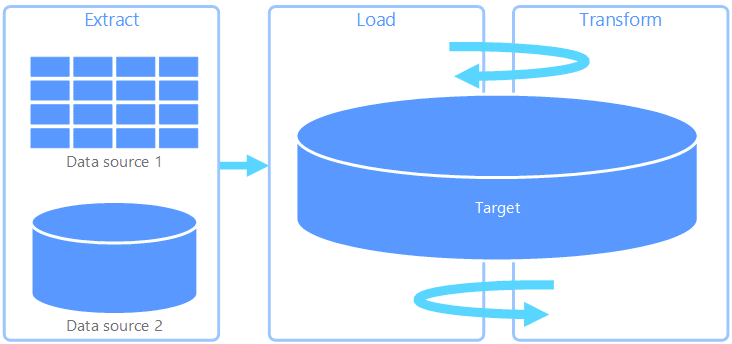
Otra ventaja del modelo ELT es que generalmente está vinculado a un lago de datos como almacén de datos de destino. Los lagos de datos se diferencian de los almacenes de datos en que no requieren que se recupere la estructura de datos de acuerdo con los esquemas. Esto permite que las herramientas que pueden trabajar con datos no estructurados, como la inteligencia artificial, comiencen a analizar y trabajar con datos más rápido cuando se transforman «en reposo».
Las diferencias entre los modelos ETL y ELT también se explican en el siguiente video:
Ahora que tenemos una mejor comprensión de ETL y su proceso, ¿cómo se implementa en el mundo real?
Casos de uso de ETL
ETL se puede usar de varias maneras para hacer crecer su negocio, incluidos (entre otros) los siguientes escenarios.
1. Almacenamiento de datos
El principio básico de ETL es centralizar la información en almacenes de datos y este sigue siendo su principal caso de uso. Recopilar, estandarizar y almacenar datos permite otros casos de uso, que analizaremos más adelante.
2. Análisis de negocio
Volviendo a nuestro ejemplo hipotético, Business Intelligence nos ha ayudado a reformular el dilema del Cliente A y el Cliente B. ETL proporciona una única fuente de verdad que permite a las empresas analizar datos de toda la organización. Armados con estos datos, los analistas pueden proporcionar a los líderes y partes interesadas estadísticas sólidas que impulsen las decisiones comerciales.
3. Aprendizaje automático e inteligencia artificial
El aprendizaje automático y la inteligencia artificial son tecnologías en rápida evolución, y los datos completos y de alta calidad son fundamentales para su funcionamiento. El aprendizaje automático es el proceso mediante el cual el software aprende y refina sus funciones sin reglas claras para definir el comportamiento, y estos algoritmos están impulsados por modelos estadísticos para definir patrones y sacar conclusiones. Estos modelos se basan en datos organizacionales, lo que hace que sea crucial garantizar que estas herramientas tengan acceso a la mejor información disponible para ayudar en la toma de decisiones.
4. Migración a la nube
Las organizaciones utilizan la nube para alojar sus datos y aplicaciones de misión crítica, principalmente de alta disponibilidad. Para asegurarse de que todos sus datos vayan a CSP, estas empresas utilizan ETL o ELT para recopilar datos de varias bases de datos locales alojadas en la nube o aplicaciones comerciales y cargarlos en el almacén de datos en la nube.
5. Integración de datos de marketing
En un mundo digital, los clientes tienen más formas que nunca de interactuar con su negocio. Los datos de comportamiento del cliente pueden provenir de fuentes digitales como plataformas de comercio electrónico, redes sociales, sitios web y aplicaciones móviles. Los datos también se pueden recopilar de aplicaciones comerciales como CRM para realizar un seguimiento de la calidad de los clientes potenciales con datos de llamadas, comportamiento de compra, tickets de soporte y otras métricas.
Esto presenta un desafío para los especialistas en marketing que buscan rastrear todos estos puntos de contacto para medir el éxito de sus campañas y la calidad de sus clientes potenciales. El ETL consolida estos datos para que los líderes de marketing y los profesionales de operaciones puedan registrar estas métricas. ETL también permite a estas partes interesadas consultar conjuntos de datos para descubrir nueva información sobre lo que está impulsando a los clientes potenciales a realizar conversiones. En otras palabras, ETL impulsa el marketing basado en bases de datos.
ETL admite estrategias de datos modernas
La cantidad de datos disponibles para las organizaciones crece con la adopción de tecnologías digitales. Además, están surgiendo nuevos métodos de interacción con los datos transmitidos, como el aprendizaje automático y la inteligencia artificial. ETL admite estas estrategias de datos modernas y sigue siendo la columna vertebral de la gestión de datos. El ETL proporciona una única fuente de verdad para una organización que puede analizar su desempeño y operaciones, tomar decisiones informadas sobre sus objetivos y avanzar en su misión.